Tool Call 优化:别让上下文成为数据中转站
工具调用成功后,如何减少无用的数据搬运?从输入引用、后端暂存、返回结构压缩、按需读取到异步续接,梳理通用的 Tool Call 数据流优化思路。
Tool Call 已经能正常执行,Agent 却仍然需要很多轮请求,上下文也越来越长。接下来该优化什么?
先看数据是怎么流动的。
一个工具读出大批数据,模型接收后,又把它们原样填进另一个工具的参数。计算返回大量中间结果,模型只用其中几项,其余内容却继续留在历史里。任务还没结束时,再多问几轮“完成了吗”。每次调用都可能成功,整条流程仍然做了很多无用功。
上一篇文章讨论了工具调用的可靠性。这篇继续往下看:怎样让模型只接触完成判断所需的信息,把数据传递、保存、计算和等待交给应用。
我们最近在行情分析工具里做了这类调整。K 线是一个直观案例:计算指标可能需要几千根数据,模型最后只需要解释几个信号。同样的设计问题,也会出现在日志分析、报表统计和批量文档处理中。下面用已实现的行情流程说明做法,其他场景作为可以迁移的设计示例。
先分清:谁需要这份数据
拿到一份很长的工具结果,先别急着换格式。先问下一步是谁要用它。
| 数据的用途 | 更合适的处理方式 |
|---|---|
| 模型需要据此判断、解释或选择下一步 | 返回必要字段、证据片段和数据范围 |
| 另一个工具需要它作为输入 | 后端保存,通过资源引用或查询参数传递 |
| 后续可能需要检查,目前还用不到 | 返回结果标识和读取入口,按需取回 |
| 只是执行进度或中间状态 | 由应用维护,必要时向用户展示 |
比如统计错误日志的出现次数,可以由工具扫描完整日志,再返回统计与代表性样本。模型需要判断某段报错的原因时,再读取相关上下文。报表统计也可以先做筛选、分组和聚合,再交给模型解释。
这里的边界取决于任务。如果用户要求逐段审阅文档内容,正文就是模型工作的输入,不能用一个文件 ID 代替。引用解决的是数据搬运,不会让模型凭空知道文件里写了什么。
长输入留在后端,调用时传参数和引用
以“计算过去一年小时 K 线的均线,找出交叉位置”为例。我们之前先返回全部 K 线,再由模型把它们填进计算工具参数。如果用户只要均线和交叉信号,这就多走了一步。这些数据是计算的输入,绝大部分不是模型判断下一步需要阅读的证据。
现在,模型把数据源、标的、周期、起止时间和计算逻辑交给 Compute。服务端根据这些定位参数读取行情,固定一份数据快照,将长输入分段保存在后端,再逐段计算。指标所需的窗口和递推状态随计算进度保存,不需要把前面所有 K 线重新放进下一次模型请求。
以前:读取全部 K 线 → 返回模型上下文 → 模型把 K 线填入计算参数 → 计算
现在:提交数据定位参数与计算逻辑 → 返回任务 ID
      → 后端读取、保存快照并分段计算 → 读取摘要或必要的结果页
这里的“参数引用”有两层:创建计算时,用行情定位参数指定要读哪段数据;任务创建后,用任务 ID 和结果游标访问已保存的执行与结果。内部队列也只传任务标识,Worker 再从数据库读取保存的请求。无需让模型反复输出长参数,也无需让队列携带整份行情。
通用的做法是让生产数据的工具返回一个可读取的资源标识,后续工具接收该引用和处理参数。对于已有的数据源,也可以直接传查询条件,由执行工具自行读取。长日志、上传文件或查询结果都可以按这个思路设计,不必经由模型完整转抄。
后端存储承担了工作期间的数据暂存,但不是放在某个 Worker 的内存里。当前实现把计算输入快照、进度检查点和结果分段保存在 PostgreSQL。Worker 替换或重试时,可以从已提交的位置继续。模型只拿任务标识、摘要和需要核对的结果页;原始 K 线和无关中间数据不会因为参与过计算,就自动进入对话上下文。
暂存也需要明确规则:引用属于谁、对应哪个版本、保留多久、过期后如何处理。每次读取都要校验权限,引用本身不能成为绕过授权的凭证;不能在引用过期后悄悄读取一份新数据。存储可以按数据大小和生命周期选择,但不能依赖某个进程一直活着。
必须返回的数据,再把重复结构压下来
确定一批数据确实要交给模型后,再看它的表示方式。查询结果、日志列表、商品目录、时序数据,都可能在每一行重复同一组字段名。以 K 线为例,几千行 JSON 对象会不断重复时间、开盘价、最高价等字段名。即使去掉缩进和空格,重复字段和对象结构仍然占据大量上下文。
这里要解决的是模型实际读取的文本体积。HTTP 传输层把 JSON 压得再小,解压后交给模型的仍是那一大段内容。因此我们把重复列名从每一行提到表头,让上下文主要承载数据本身。
通用原则是按数据形状选择表示方式:单条对象保留清晰字段,同结构的多行数据共享列名,长正文避免层层包装。我们的实现是为新 Service Tool 结果定义版本化文本协议 QRP1。单条记录用 record,表格用 table,时序数据用 series,正文用 text,简短执行回执用 receipt。模型直接读取这个格式,不需要先转回 JSON。QRP1 是这里的工程选择;其他系统可以使用已有的表格或紧凑文本约定,前提是模型能理解,程序能验证。
具体到当前实现,K 线读取使用固定的 dt_ms,o,h,l,c,v,closed 列;Compute 表格使用计算任务定义的列;通用嵌套对象则展开为 path,value_type,part,parts,value。它们都能使用 QRP1,但不是同一种压缩方式。
下面用两根虚构 K 线说明专用时序编码。示意只保留关键字段;实际 t0、columns 与来源、快照、分页等信息一起写在同一行 QRP1|... 协议头中:
# 原来的对象数组
[{"time":"2026-09-08T00:00:00Z","open":100,"high":103,"low":99,"close":102,"volume":25.4,"closed":true},
 {"time":"2026-09-08T01:00:00Z","open":102,"high":104,"low":101,"close":103,"volume":21.8,"closed":true}]

# 紧凑时序的数据区示意
 t0=2026-09-08T00:00:00Z
 columns=dt_ms:i64,o:f64,h:f64,l:f64,c:f64,v:f64,closed:bool
 0,100,103,99,102,25.4,1
 3600000,102,104,101,103,21.8,1
dt_ms 是相对于固定起点 t0 的毫秒偏移;翻页时起点不变。closed 保留 K 线是否已确认的信息。空值、布尔值、特殊字符转义也有统一规则,不能为了短就让空值和空字符串混在一起。
这一步省的是重复结构,不能顺手删掉来源、时间范围、错误原因和执行状态。小记录未必比 JSON 更短,复杂嵌套结果展开后也未必更省;重复列较多的长表格才是更直接的受益场景。下面的实验会分别测量字节数和 Token,验证这些差异,不能拿字符数变化冒充 Token 收益。
先返回够用的信息,再按需读取明细
大结果的第一次返回,应当足够支持下一步判断,并说明数据范围和后续读取方式。例如日志分析先给错误分布和样本位置,报表统计先给汇总和明细入口。模型需要核对证据,或用户要求展开时,再读相关部分。摘要不能冒充完整结果,抽样也要明确标注。
在行情案例里,用户要求“展开所有交叉记录”时,可以继续读取明细。结构变短以后,大结果仍然可能塞满上下文。我们给每次返回设置字节上限,超出的部分通过 next_cursor 继续读取。这个上限约束的是一页,不是整个查询、计算或文件处理能覆盖多少数据。
分页还必须绑定固定的数据快照。否则第一页读完,数据更新了,第二页可能重复或漏行。现在游标绑定查询、结果版本、排序和快照;在保留期内重复读取同一个游标,得到同一逻辑页。过期或不匹配就明确报错,不悄悄换一份新数据。
分页提供的是按需查看明细的能力。如果每一页最终都被自动读进上下文,分页只是把一次大返回拆成了多次小返回,没有减少模型需要阅读的总量。能在后端筛选或聚合的,应当先处理,再返回。
长任务的等待,交给应用来做
长区间计算、批量导出、日志扫描等任务,都可能超过一次工具执行的时间。任务没有新信息时,反复返回“运行中”并不能帮助模型判断下一步。让模型不停问“好了没有”,还会增加请求数,把相同状态塞进上下文。
这一类任务可以先返回任务标识,把进度交给应用展示。等模型确实需要的结果就绪,再继续推理。我们当前的服务端工具采用下面的实现:把“等哪个结果”存进数据库,先结束当前这轮执行。等结果就绪后,再带着结果发起下一轮模型请求。具体分成四步:
- 登记等待。 读取结果时,如果后台任务还没结束,就保存会话 ID、原来的
toolCallId、后台任务 ID 等信息。会话进入awaiting_server_tool状态,当前这轮执行结束,后台计算继续。 - 记录完成事件。 任务完成或失败后,写入数据库中的待投递事件表,也就是 outbox。它像一张“待办通知”:这个任务有结果了,需要送回对应会话。Worker 重启后仍能继续处理。
- 补回工具结果。 Worker 读取事件和实际结果,将结果编码为 QRP1,再向会话历史添加一条
role: tool消息,沿用原来的toolCallId。下一轮模型因此能把答案和之前的调用对应起来。 - 创建续接请求。 系统创建类型为
server_result的后续执行并放进队列。模型收到之前的对话和刚补上的工具结果,就能继续分析、调用工具或回答用户。
这里没有让一次模型请求一直挂着等。后台 Worker 仍会检查待投递事件,但等待期间不需要调用模型来问进度,也不会反复把“还没完成”塞进上下文。
防重复靠的是数据库事务和状态检查。补回结果、创建后续执行、更新等待和事件状态一起提交。重复事件到达时,已经交付过就跳过;用户已经中断等待,旧事件也不能再触发这次续接。这样,服务端可以重试投递,而同一个工具调用只收到一次结果。
还有一个容易漏掉的时序:任务可能在等待记录建好之前就结束了。登记等待时也会检查任务是否已经进入终态;如果已经结束,就补建待投递事件,避免结果明明存在,会话却一直等下去。
结果可以短,失败原因不能省
优化后的结果至少还应说明:是否成功、涉及哪个资源或版本、数据是否完整、下一步能做什么。失败时需要稳定的错误码和可安全提供的原因,不能只剩一句“处理失败”。
失败也要走这条结果链路。我们修复了一个容易误导模型的情况:任务已经失败,但调用参数又带了错误游标,返回的却是分页错误。现在优先返回该任务的终态和安全错误原因,让模型知道应该修代码或参数。副作用是否发生仍然无法确认时,保留 outcome_unknown,不能靠自动重试掩盖不确定性。
用当前编码器跑一组对比
为了看清格式和数据流各自的收益,我们用当前代码做了一组可复现的载荷实验。输入是确定性生成的合成数据,没有读取真实用户数据,也没有调用模型。下列 Token 均由 o200k_base 分词器对文本实际计数,不等同于线上模型的计费 Token,也不是耗时或成功率测试。
数据量增大后,专用格式能省多少
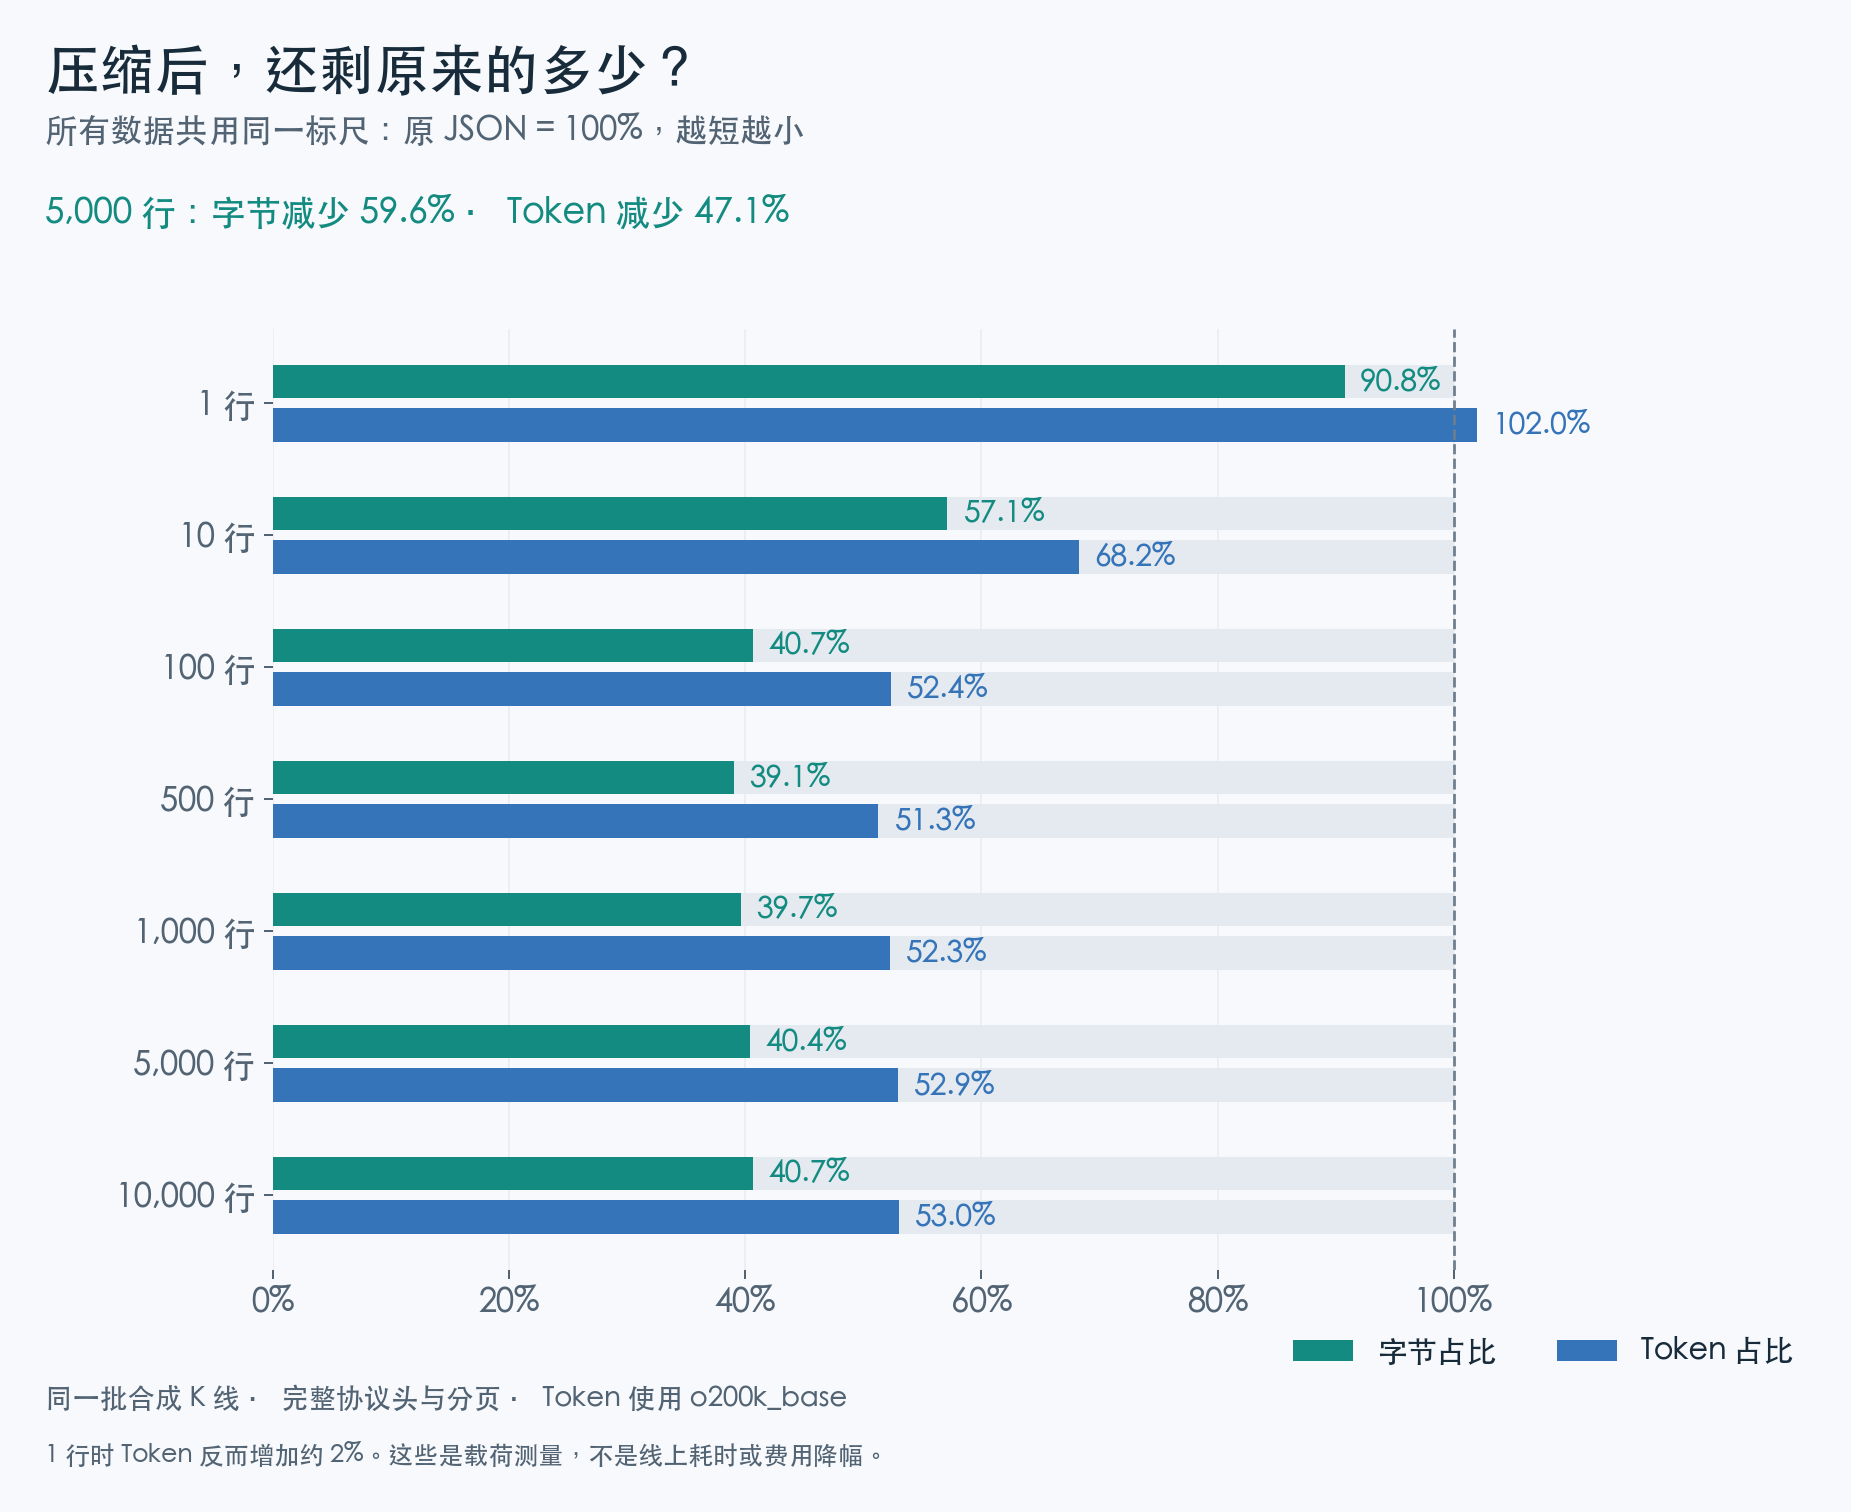
K 线样本从 1 行增加到 10,000 行,每页最多 500 行。两边都保留相同的数据值、来源、范围、快照和分页含义:JSON 使用无缩进的紧凑对象数组,QRP1 使用当前 K 线编码器。统计包含全部页的协议开销;需要续页时,双方都使用固定 384 字节的合成游标,以便复现。
图中把每组原 JSON 都设为 100%,字节和 Token 共用同一百分比标尺。彩色条是 QRP1 保留下来的大小,灰色部分表示省掉的体积;超过 100% 则表示变大。
| 记录数 | JSON 字节数 | QRP1 字节数 | 字节减少 | JSON Token | QRP1 Token | Token 减少 |
|---|---|---|---|---|---|---|
| 1 | 649 | 589 | 9.2% | 253 | 258 | -2.0% |
| 500 | 61,200 | 23,910 | 60.9% | 26,163 | 13,416 | 48.7% |
| 5,000 | 617,470 | 249,591 | 59.6% | 265,311 | 140,360 | 47.1% |
| 10,000 | 1,235,675 | 503,006 | 59.3% | 531,332 | 281,709 | 47.0% |
这里的“减少”按 1 − QRP1 大小 / JSON 大小 计算。只有一行时,QRP1 的 Token 反而多了约 2%;协议头还没被足够多的数据摊薄。到了 5,000 行,字节减少 59.6%,Token 减少 47.1%。两种比例不同,所以不能用文件大小直接估算上下文收益。
通用对象展开,不一定能压缩
我们还生成了 500 条商品形状的记录,每条有 ID、名称、价格和启用状态,用当前通用对象展开函数编码。它产生 2,000 条路径和值记录,再按每页 300 条展开记录编码。对照基线是完整的紧凑 JSON 对象,图中包含展开后的路径、类型、分片和分页元数据开销。
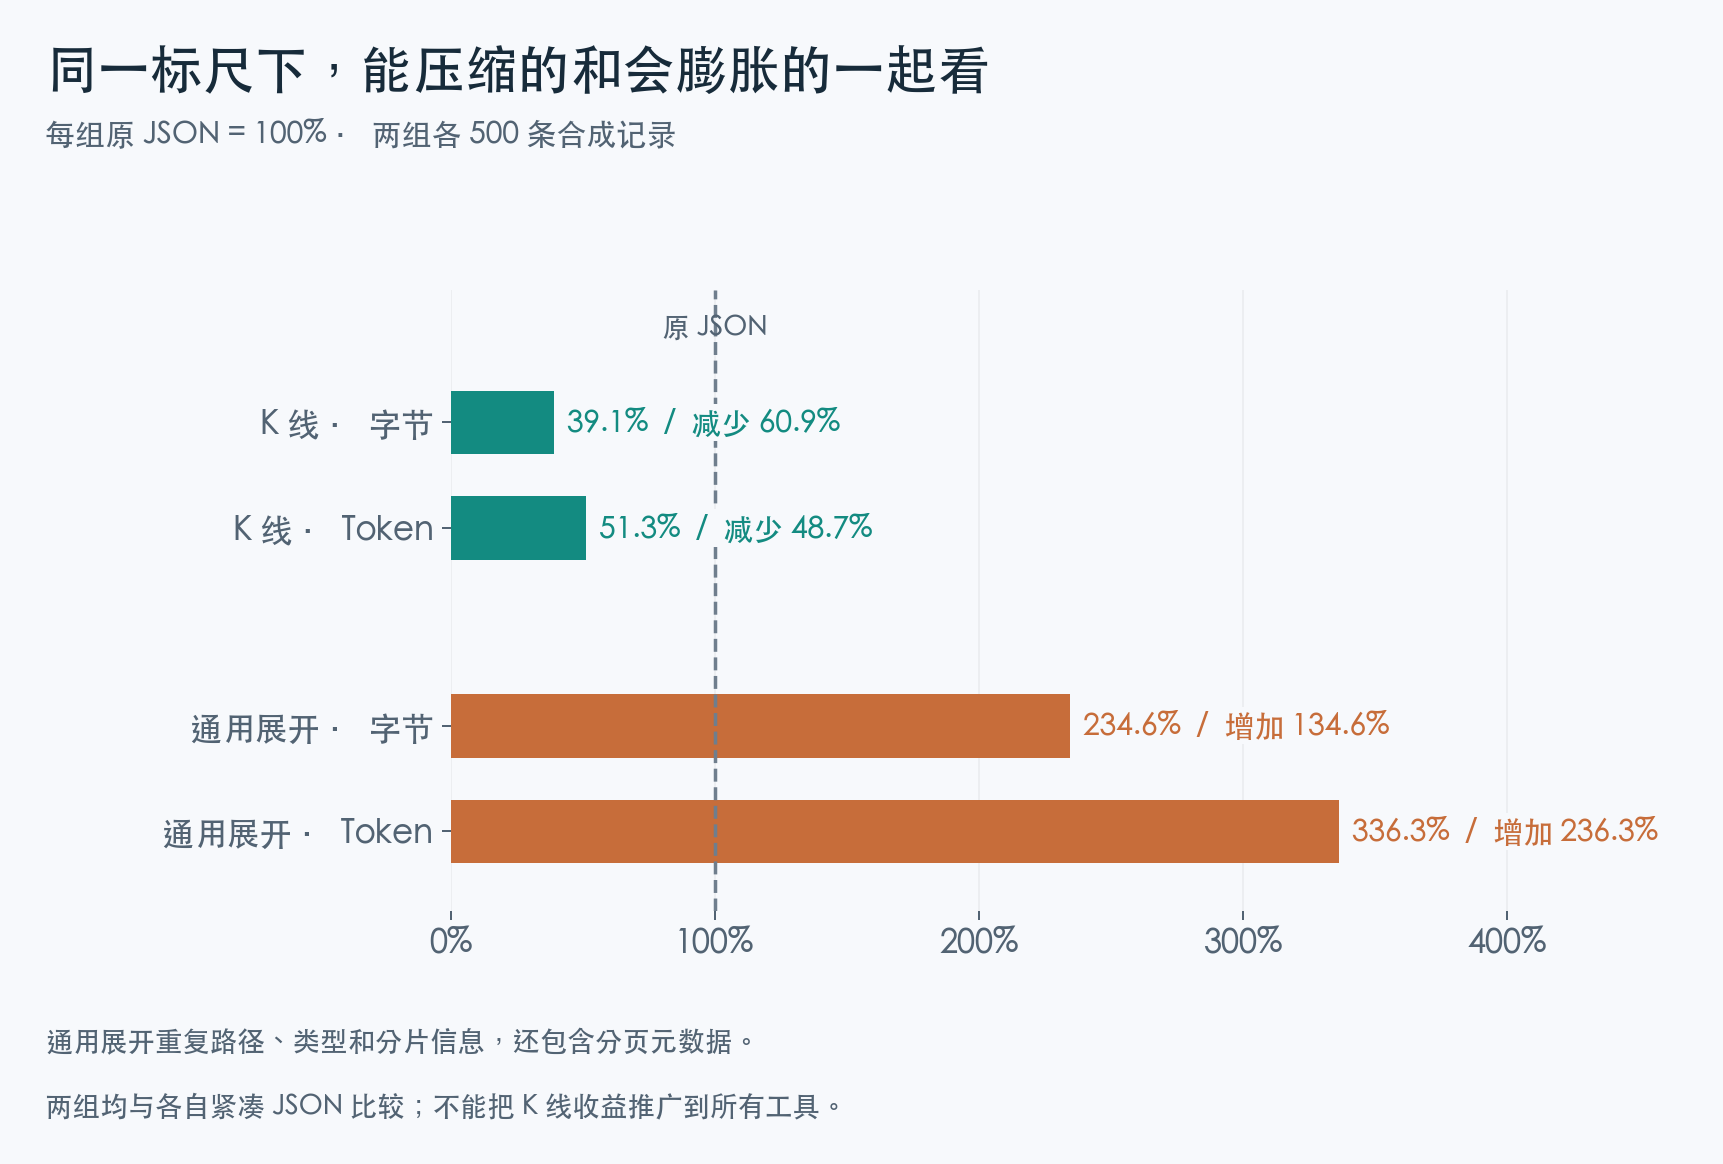
这组通用对象从 34,968 字节变成 82,029 字节,Token 从 11,405 变成 38,357。展开格式保留了确定的路径和类型,也方便分段读取,但不保证省空间。不能把 K 线专用编码的收益推广成“所有工具返回都能压缩一半”。
这也指出了进一步优化的方向:对于经常返回同结构列表的工具,可以评估专用列式结果,而不是让每个值都重复一段字段路径。这里是根据样本提出的改进方向,并未将其写成已完成的改动。
只压缩返回值,仍然可能搬运两遍数据
最后固定为 5,000 行,构造三种输入传递方式:先返回 JSON 再把原始数据放进下次参数;先返回 QRP1、但下次仍转抄原始数据;直接提交数据定位参数,让服务端读取。
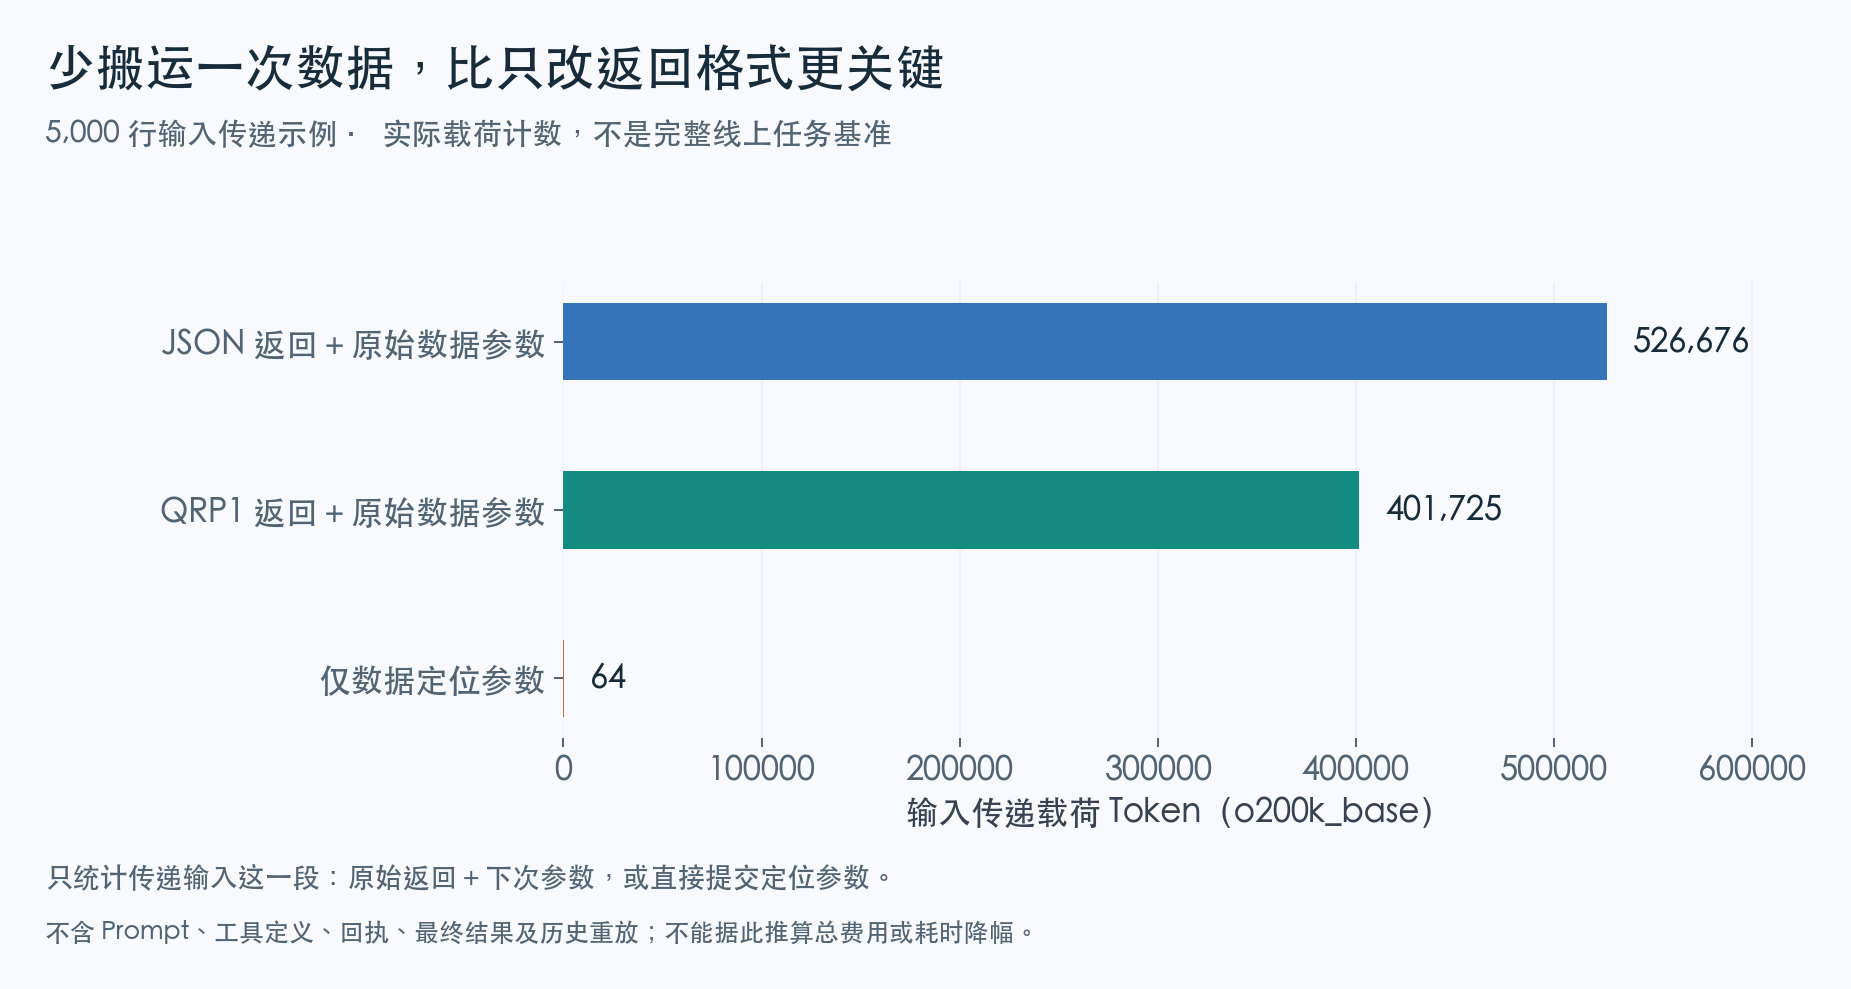
这里统计的是输入传递这一段载荷,不是完整任务。参数中的计算逻辑用固定占位文本表示,三组不执行实际计算;未计入 Prompt、工具定义、任务回执、最终结果和历史重放。64 Token 只是这份示例定位参数的大小,不代表一个计算任务只花 64 Token。
即便只看这个受控示例,区别也很明确:返回格式变短以后,如果模型仍然要输出全部原始数据作为下一个工具的参数,很多搬运成本仍然存在。直接让工具按参数读取数据,才能把这部分长输入移出模型上下文。
完整数值可以下载为 CSV 或 JSON。这些结果说明本组数据的表示和传递成本,线上收益还要用实际任务验证。
这轮优化,应该怎么衡量
这些做法解决的是不同的浪费:引用减少转抄,后端处理减少中间数据,紧凑格式减少重复结构,按需读取减少无用明细,异步续接减少等待期间的模型请求。可以根据工具的数据流分别采用,不需要为一个小结果搭建整套后台任务系统。
这个变化要同时看三组证据:
- 上下文负担: Tool Result 和调用参数各有多少字节、多少实际 Token,长输入是否仍被复制进后续请求。
- 工作量: 一个任务调用了多少次模型、多少次工具,等待期间是否还有模型轮询,完成任务总共用了多久。
- 结果正确性: 分段处理是否与同一份完整输入的处理结果一致,分页是否漏行或重复,失败是否保留原因,结果是否只回填一次。
在我们的行情工具里,可以确认的是数据路径和续接机制已经改变。本次实验测到了合成载荷的字节和 Token 差异;完整任务节省多少 Token、缩短多少耗时,还需要用同一组任务和目标模型测量,不能把格式变短直接写成任务更快。
以后再遇到一份很长的 Tool Result,我们会先问:模型下一步真的需要读完它吗?如果只是另一个工具需要这些数据,就让后端用引用把它接过去。模型的上下文,留给任务要求、判断依据和真正需要解释的结果。