Vibe Coding 到 44 万行:不看代码,靠什么让项目不失控?
以策脉的 5 个应用、11 个共享包和 174 个数据库迁移为例,说明项目负责人不审代码时,怎样用 Spec、状态权威、测试和发布闸门管理风险。
我最近让 Codex 统计了一次策脉的工程规模。
结果比“这个项目已经挺大”具体得多:Git 跟踪 3,574 个文件,生产代码约 29 万行,测试代码约 14.8 万行。整个项目有 5 个可独立运行的应用、11 个共享包、174 个数据库迁移和 56 份正式 Spec。
这些数字不等于产品质量,也不能证明每一行代码都有必要。但它们至少说明一件事:这早就不是靠记忆就能管住的小项目了。
更特别的是,我并不审查这些代码。大部分实现、重构和测试由 AI 完成。我主要看产品决定、规范冲突、验证证据和上线结果。
所以问题不是“AI 能不能写出 44 万行代码”。它当然能。真正的问题是:当人不再逐行看代码,谁来阻止一次局部正确的生成,把整个系统悄悄改错?
先说清楚:不看代码,不等于没人看代码
这里的“不看代码”,是项目负责人不再把逐行 Code Review 当作主要控制手段。
AI 仍然必须读代码。它要检查现有实现、调用方、消费者、状态归属、测试和历史决定。机器还要执行类型检查、静态检查、测试、构建和发布验收。
人负责回答另一类问题:
- 用户最终应该看到什么结果?
- 哪些业务事实绝对不能被改写?
- 发生失败、冲突和未知结果时,产品应该怎样表现?
- 兼容旧数据要付出什么代价?
- 哪一种风险值得现在承担?
如果连 AI 都不读现有实现,只拿一段新需求覆盖上去,那不叫规范驱动,更像蒙着眼睛整理一个已经住满人的房间。
44 万行代码里究竟有什么
这次统计读取当前工作区中的 Git 跟踪文件,排除了 node_modules、构建输出和未跟踪文件。行数是物理行,包含注释和空行。
| 维度 | 当前规模 |
|---|---|
| Git 跟踪文件 | 3,574 |
| 生产代码 | 约 289,800 行 |
| 测试代码 | 约 147,800 行 |
| TypeScript / TSX | 约 365,800 行 |
| Go | 约 34,200 行 |
| SQL | 约 19,100 行 |
| Rust | 约 180 行 |
| 测试文件 | 918 |
| 数据库迁移 | 174 |
| 正式 Spec | 56 份,约 37,600 行 |
测试代码大约相当于生产代码的 51%。这不等于测试覆盖率是 51%,只是说明“怎样证明行为没有坏掉”已经成为工程里的主要工作,而不是顺手补两条断言。
Rust 的行数很少,但它值得单独列出来。Worker 通过 Node-API 加载这段原生内核,用它执行 A 股筹码重放里最密集的价格档衰减、成本重映射和三角分布累加。TypeScript 继续负责输入校验、业务状态、取消、分页和结果汇总,Rust 只接管经过测量的计算热区。
在 Apple M4 上进行的七次计时中,排除两次预热后,4,096 日完整重放的中位数从 TypeScript 的约 1,724 毫秒降到 Rust 路径的约 98 毫秒,约为 17.5 倍。这个数字只适用于筹码重放,不代表整个 Worker 或产品快了 17.5 倍;两条路径还必须保持逐项结果完全一致。
它会构建成 5 份经过哈希校验的 .node 文件,覆盖 macOS arm64,以及 Linux x64/arm64 的 glibc 和 musl 环境。约 380 MB 的本机构建 target 目录被 Git 忽略,编译产物也不按文本行统计。这就是为什么 Rust 在代码总量里几乎看不见,却在架构上很重要。
策脉本身是一条量化研究与执行链路。用户可以发现市场、形成研究判断、建立策略、冻结版本、历史回测、模拟运行,再谨慎地进入实盘或只接收通知。它还包含 Agent、实时行情、文档、订阅支付和独立运维能力。
所以它的复杂度不只来自代码量。真正难的是:浏览器、异步 Worker、实时连接和多个数据库同时参与一个用户结果时,哪一份状态才算数。
这张架构图里,最重要的不是技术名字
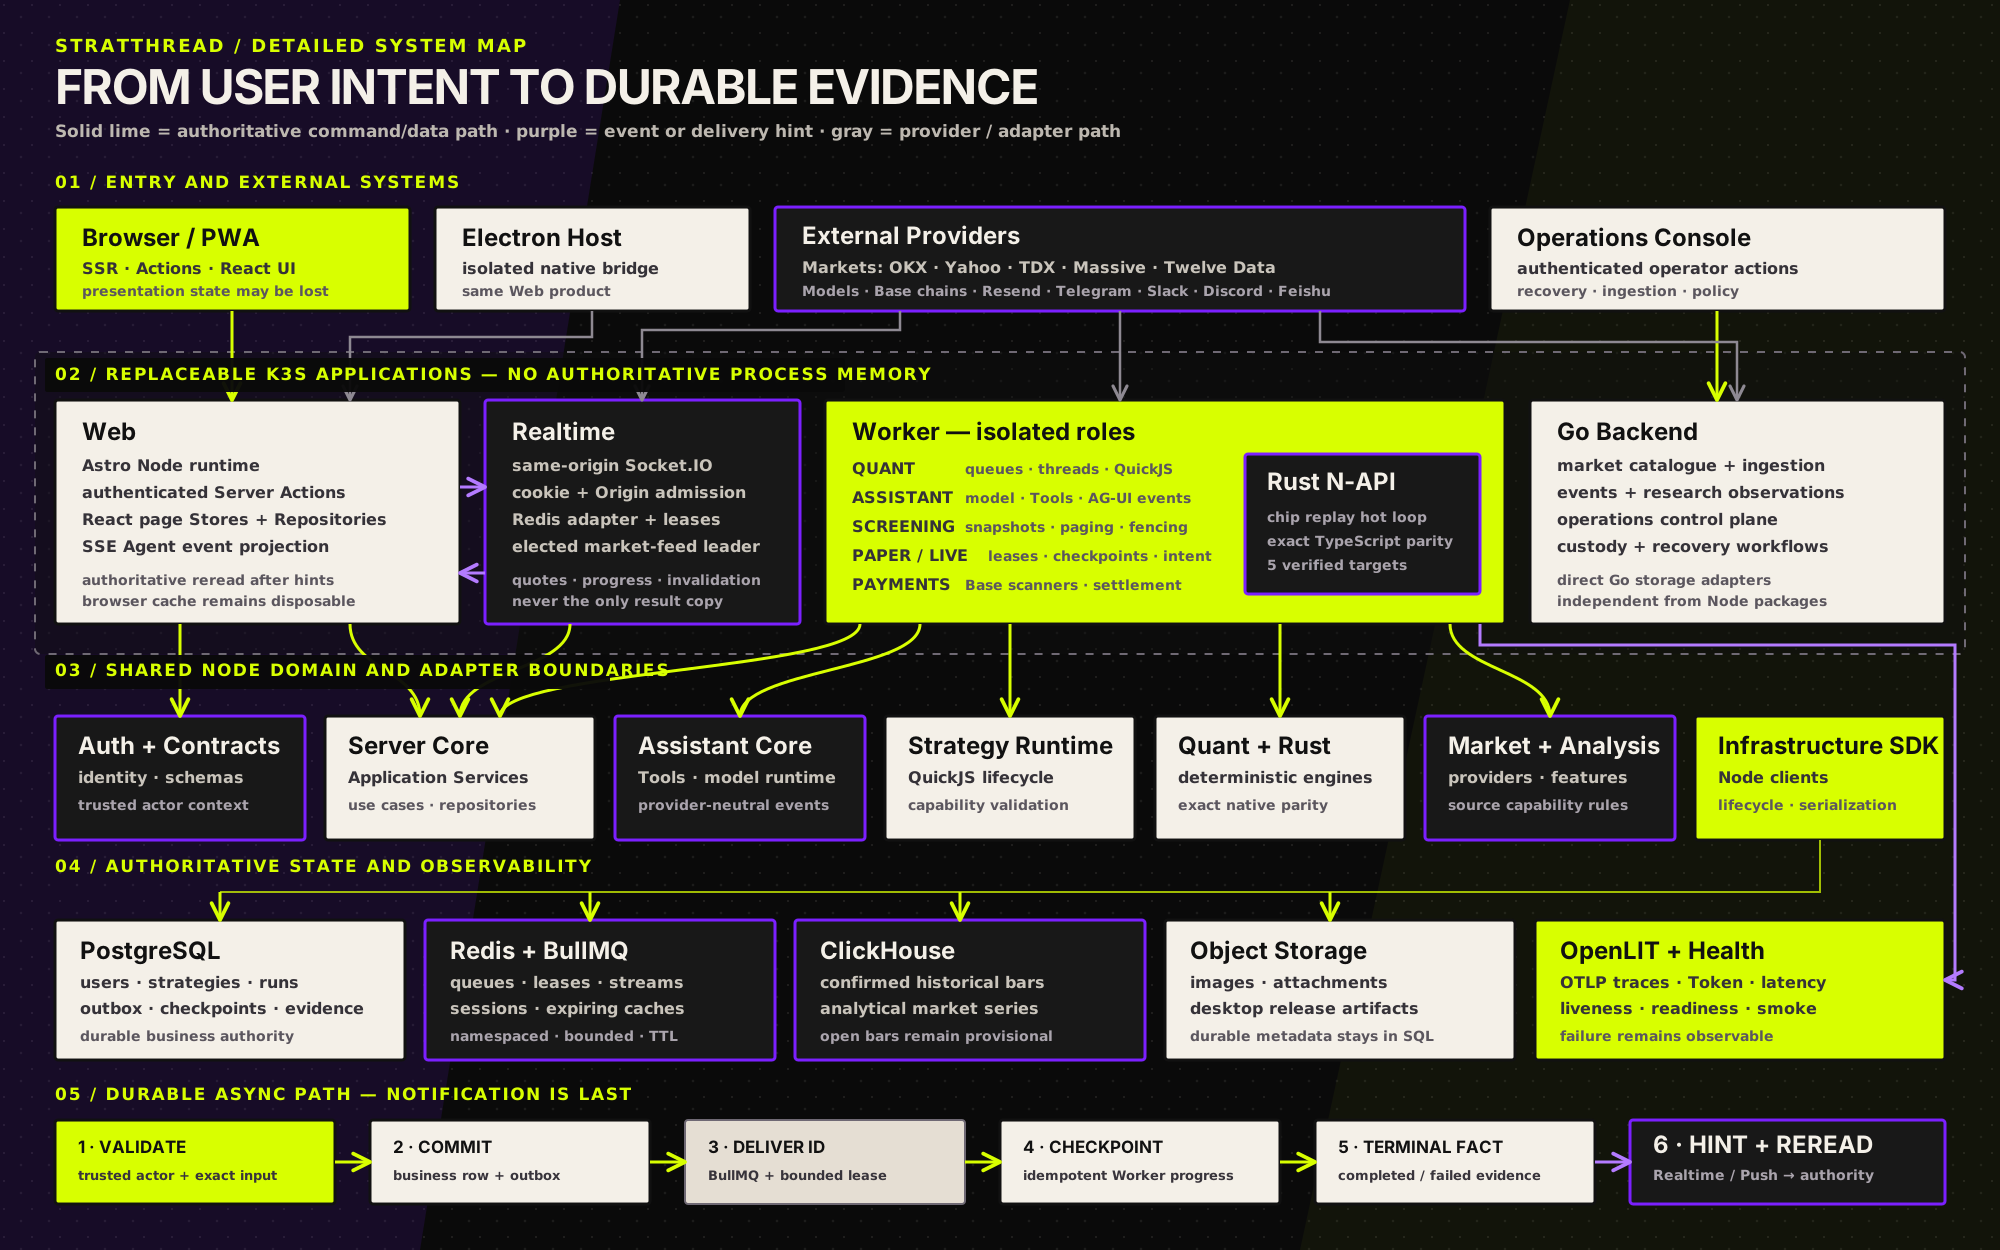
这张图把主要运行边界、Worker 角色、外部依赖、共享包、存储权威和异步交付顺序画在了一起。点击图片可以查看完整尺寸。
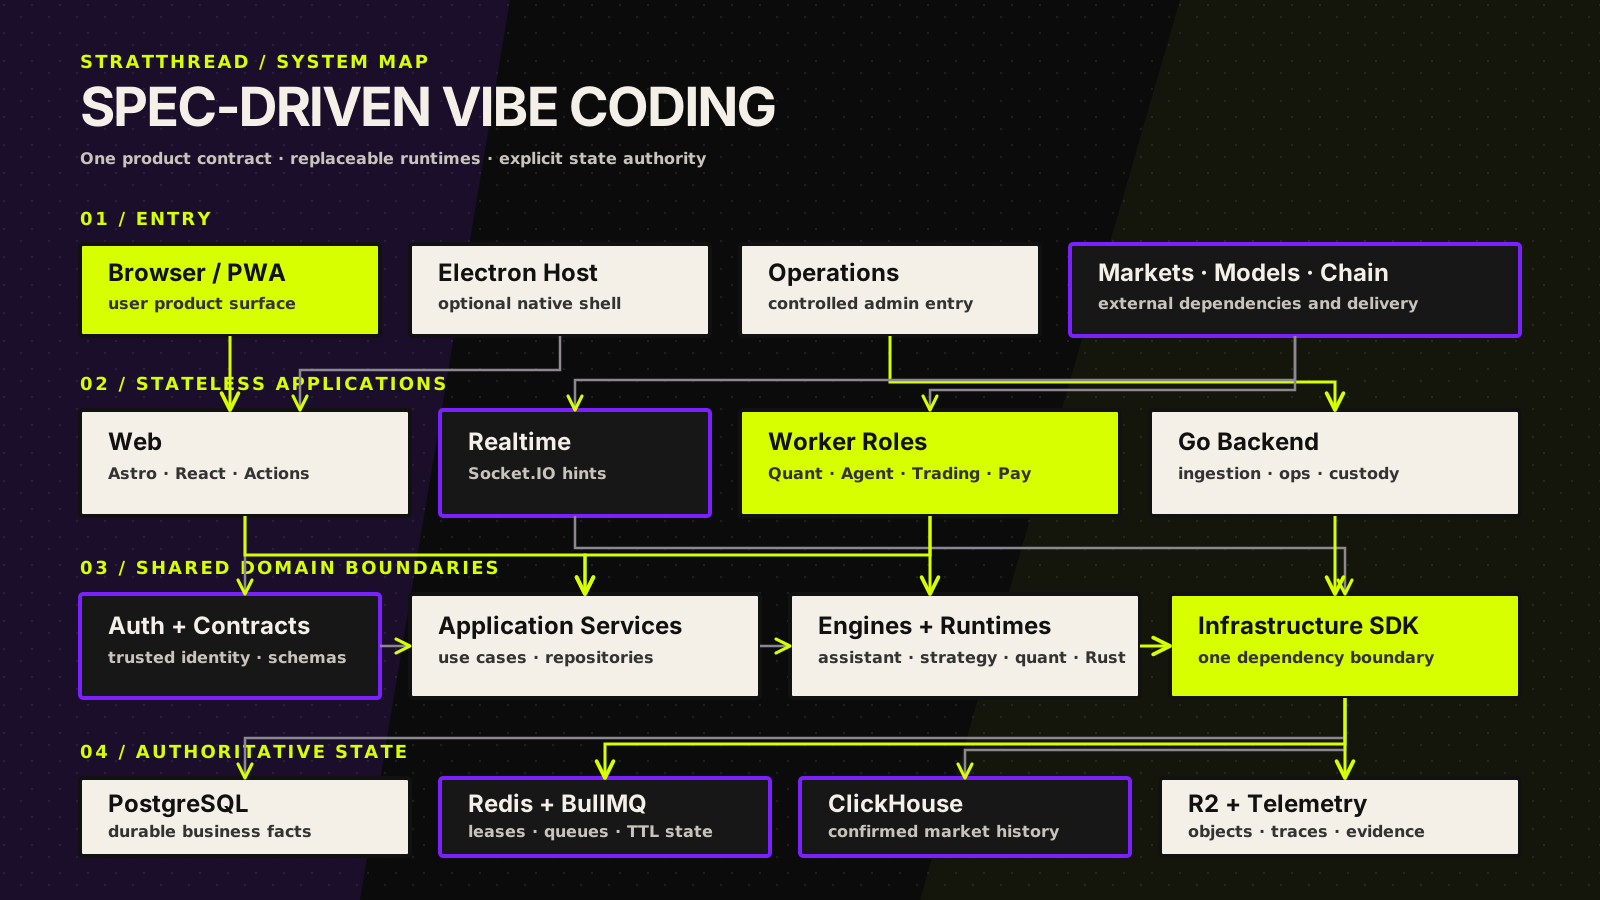
策脉现在有五个主要应用边界:
| 应用 | 主要责任 |
|---|---|
| Web | Astro 服务端渲染、React 交互和经过认证的 Actions |
| Realtime | 行情、进度、失效和通知提示 |
| Worker | 回测、Agent、筛选、模拟盘、实盘和支付任务,以及 Rust Node-API 计算热区 |
| Go Backend | 行情采集、运维控制和受控资金操作 |
| Native Wrapper | 用 Electron 承载同一个 Web 产品的可选桌面能力 |
这些应用都是可替换的。任何实例重启,都不能带走用户策略、任务、结果、账户或审计记录。
持久业务事实进入 PostgreSQL;队列、租约、会话和限时缓存进入 Redis;确认后的历史行情进入 ClickHouse;图片和大对象进入对象存储。Realtime 可以告诉页面“结果有变化”,但它不是结果本身。
这条架构约束比框架选型重要得多。AI 很容易为了完成眼前需求,临时增加一个内存 Map、本地文件或浏览器单例。只要 Spec 明确写着“实例可以随时消失”,这类捷径在动手前就不成立。
规范不是产品介绍,而是人和 AI 之间的决策接口
一份真正能指导实现的 Spec,至少要回答下面六类问题:
| 规范内容 | 它阻止什么 |
|---|---|
| 用户可观察结果 | AI 只完成按钮或接口,却没完成用例 |
| 领域对象与稳定身份 | 同一件事在不同入口产生不同名字和规则 |
| 状态权威与保留周期 | 缓存、页面和数据库都认为自己是真相 |
| 允许与禁止的状态变化 | “顺手”跳过审核、版本或权限边界 |
| 失败、冲突与未知结果 | 用空数组、旧数据或假成功掩盖故障 |
| 可复现的验收点 | 只能凭截图或一句“测试通过”判断完成 |
比如“增加一个回测按钮”远远不够。更可执行的描述应该说明:谁可以提交、精确冻结哪个策略版本、接收成功后先保存什么、重复提交是否产生第二个任务、Worker 重启后从哪里恢复、失败时保留哪些证据,以及页面最终读哪一份记录。
写到这个程度,AI 不需要猜产品规则。人也不需要通过读实现来寻找隐藏决定。
每次改动先过准入,不是拿到需求就开写
我把变化分成三个风险等级:
- Fast:不改变用户合同的修复、重构和维护。
- Standard:新功能、交互、API、协议或持久数据含义发生变化。
- Critical:数据库迁移、认证、权限、密钥、支付、资金、生产基础设施和不可逆操作。
Standard 和 Critical 变化必须先修改拥有该行为的永久 Spec,再修改运行时代码。Fast 变化也要引用已经存在的不变量和回归点;如果规则写得含糊,就自动升级为 Standard。
还有一条很重要:当两份当前 Spec 不一致,或者新方案与历史决定冲突时,AI 不能按“新文档优先”“更具体的优先”或“现有代码方便”自己选答案。
它要停下来,把拟议行为、冲突条款、当前实现、兼容选项、迁移代价和需要人决定的问题摆出来。人只处理这个决定,不必下沉到某个函数该怎么写。
让 AI 写代码,但不让 AI 宣布自己正确
一次改动在策脉里会经过下面这条路径:
用户意图
  -> 风险分级
  -> 永久 Spec 或现有不变量
  -> Pending Fragment 记录需求、验证和回滚
  -> AI 检查现有代码、调用方与历史
  -> 最小完整实现
  -> 修改范围内的测试、类型检查、Lint 和构建
  -> 固定 Release Candidate
  -> 发布前全量回归与专项安全门
  -> 部署不可变制品
  -> 生产健康检查、Smoke 与可观测证据
  -> 最终版本记录
这里最容易偷懒的是“验证”。
“测试通过”不是证据。记录必须写出实际执行的命令、检查范围、结果和限制。没有执行的检查写 Not run,缺少必要权限、凭据、恢复证据或外部条件时写 Blocked。必需项处于这两种状态,就不能发布。
测试也不应该只从页面一路点到底。纯领域规则用纯函数测试;应用服务和 Store 注入 Fake Repository;协议与数据库映射放在适配器测试;只有真实交互、焦点、响应式和无障碍才进入浏览器。
便宜的错误尽量在便宜的地方发现。否则一个字段校验也要启动完整系统,最后大家只会因为太慢而绕过检查。
异步任务先留下记录,再通知 Worker
回测、Agent、模拟盘和实盘任务都可能跑很久。浏览器会关闭,Worker 会重启,队列可能重复投递。
所以接收异步任务时,顺序必须是:
校验
  -> 保存已接收业务记录与 Outbox
  -> 投递稳定 ID
  -> Worker 从正式存储读取冻结输入
  -> 保存运行检查点
  -> 保存成功或失败的最终证据
  -> 最后发送 Realtime 或 Push 提示
先通知、后保存很危险。服务如果刚好死在中间,队列会拿到一个根本不存在的任务。
队列也按“至少一次”设计。同一消息到两次,要恢复同一个业务事实,不能生成两个结果。Redis 租约只负责协调谁现在可以做,PostgreSQL 检查点才负责回答任务做到哪里。
这就是为什么“无状态”并不等于“没有状态”。它只是要求状态回到正确的主人手里。
能保证的不是永不出错,而是错误不能一路绿灯
软件无法诚实承诺永远不崩。依赖会超时,网络会分区,人和 AI 都会理解错需求。
更实际的目标是建立下面这些可验证性质:
- 生成代码违反类型、协议或已知不变量时,发布前会失败。
- PostgreSQL、Redis 或外部依赖失败时,系统不会伪造空结果或成功状态。
- 任意应用实例消失时,业务事实仍然可以从权威存储恢复。
- Realtime 消息丢失时,页面能通过正式读取重新对账。
- 数据库迁移没有精确目标、兼容和恢复证据时,执行会被阻止。
- 新版本上线异常时,发布流程能停止、保留证据并恢复旧工作负载。
换句话说,我不要求 AI 一次写对。我要求工程有能力拒绝一份没有被证明正确的结果。
我实际会怎样向 AI 提需求
下面这段提示词,比“帮我做完这个功能并保证没问题”有用得多:
按照项目根目录 AGENTS.md 和现行 Spec 执行这个需求。

先只读检查 owning Spec、相关历史、调用方、消费者、状态归属和现有测试,
并将变更判定为 Fast、Standard 或 Critical。

如果现行规范缺失、互相冲突,或需求会改变安全、权限、支付、Schema、
状态权威和失败语义,停止实现,只向我提出需要决定的产品问题。

Standard/Critical 变更必须先更新永久规范和可验证的验收点,
再实现最小完整改动。不得修改、覆盖或提交无关工作。

完成后运行变更范围对应的测试、类型检查、Lint 和构建,记录真实结果、
未运行项、兼容与回滚方案,以及索引影响。任何必需检查失败都不得声称完成、不得发布。
这段话不会自动让项目安全。它必须与真实的 Spec、可执行测试、版本记录和发布权限结合。只把提示词写得很严,却允许红灯继续上线,最后还是靠运气。
人不看代码以后,应该把注意力放在哪里
代码规模继续增长时,我更关心这些问题:
- 新能力是否进入了正确领域,而不是让一个大模块继续变大?
- 每一种状态是否只有一个最终权威?
- 一个实例重启、一次重复投递和一条迟到响应会发生什么?
- 测试记住的是产品行为,还是某次生成代码的偶然结构?
- 发布证据是否来自精确候选版本?
- 回滚以后,哪些已经发生的业务事实必须保留?
逐行看代码曾经是获得信心的主要方式。到了 44 万行,它既不现实,也不一定有效。一个人即使读完一个文件,也很难同时记住五个应用、多个存储和一百多次迁移之间的全部约束。
更可持续的做法,是把人的判断写进规范,把规范变成测试和发布闸门,再让每一次生产结果反过来提供证据。
人可以不读代码,但系统不能只相信生成代码的人。